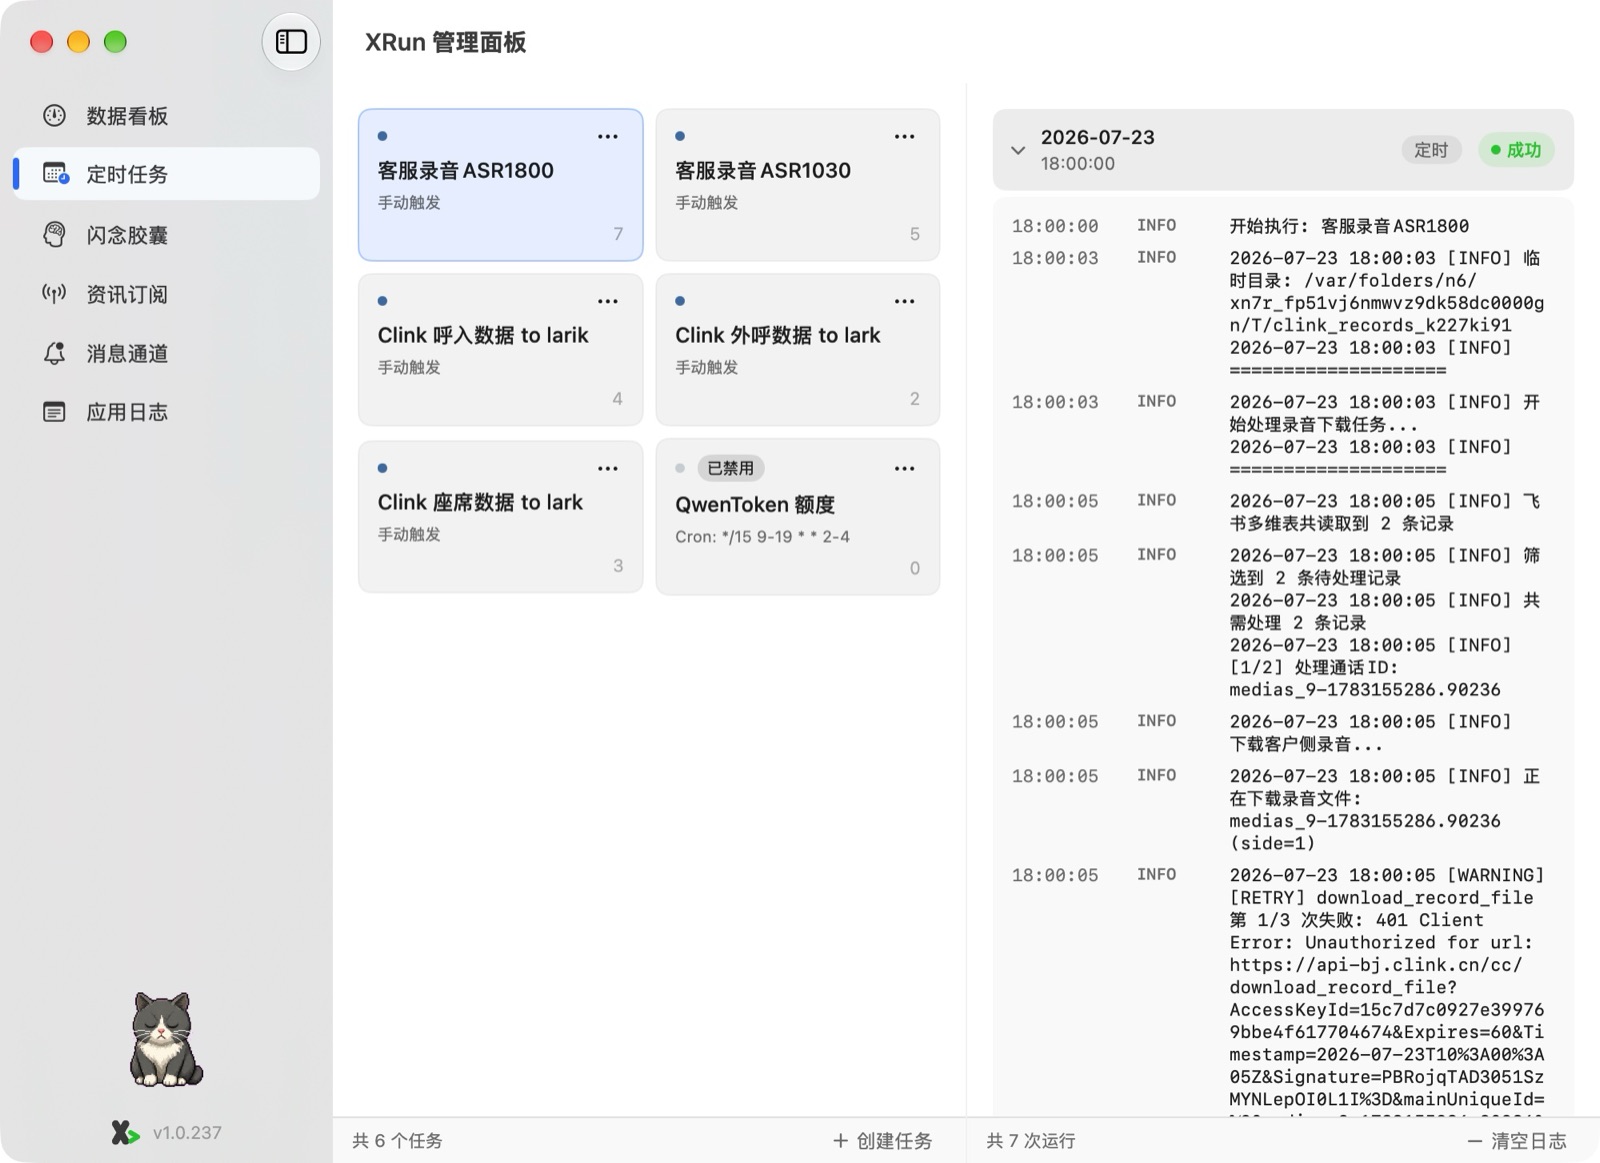
01 定时任务
把任意 Python 脚本变成可靠的定时任务。
- 8 种调度:手动 / 一次性 / 间隔 / 每小时 / 每天 / 每周 / 每月 / Cron
- 状态机空闲→运行中→成功/失败,菜单栏图标同步变色
- 日志按「执行批次」分组,可展开看单次完整输出
- 超时保护默认 1 小时且可单独配置;同一任务未跑完则本轮自动跳过
起因是运营工作里那些必须重复做、又不该占用人力的事:脚本要定时跑、结果要有人看、失败要有人知道。 找不到顺手的现成方案,于是我用 Swift 自己写了一个—— 11,615 行原生代码、6 个模块、237 个构建版本,至今仍在自己的 Mac 上每天运行。
大部分效率工具的结局是「装了但不用」。XRun 的起点不是技术选型,而是四个具体摩擦点。
cron 不感知笔记本休眠——合盖一晚上,早该跑的日报就不会跑,且毫无提示;范围收得很窄:只做一个人真正会天天用的工具。不做的事同样明确:不做多用户与权限体系、不做云端同步、不引入服务端。 这些取舍换来零部署成本、数据完全本地、离线可用——也正因如此它才活了下来,没被我自己弃用。
运营场景需要「随时瞄一眼」,而不是「专门打开一个网站」。菜单栏让状态永远在余光里: 灰色空闲、蓝色运行中、绿色今日全成功、红色则意味着需要处理——零点击即可感知系统健康度。 这也意味着必须写原生应用,因为要深度调用系统的休眠唤醒、锁屏、前台应用与进程管理等能力。
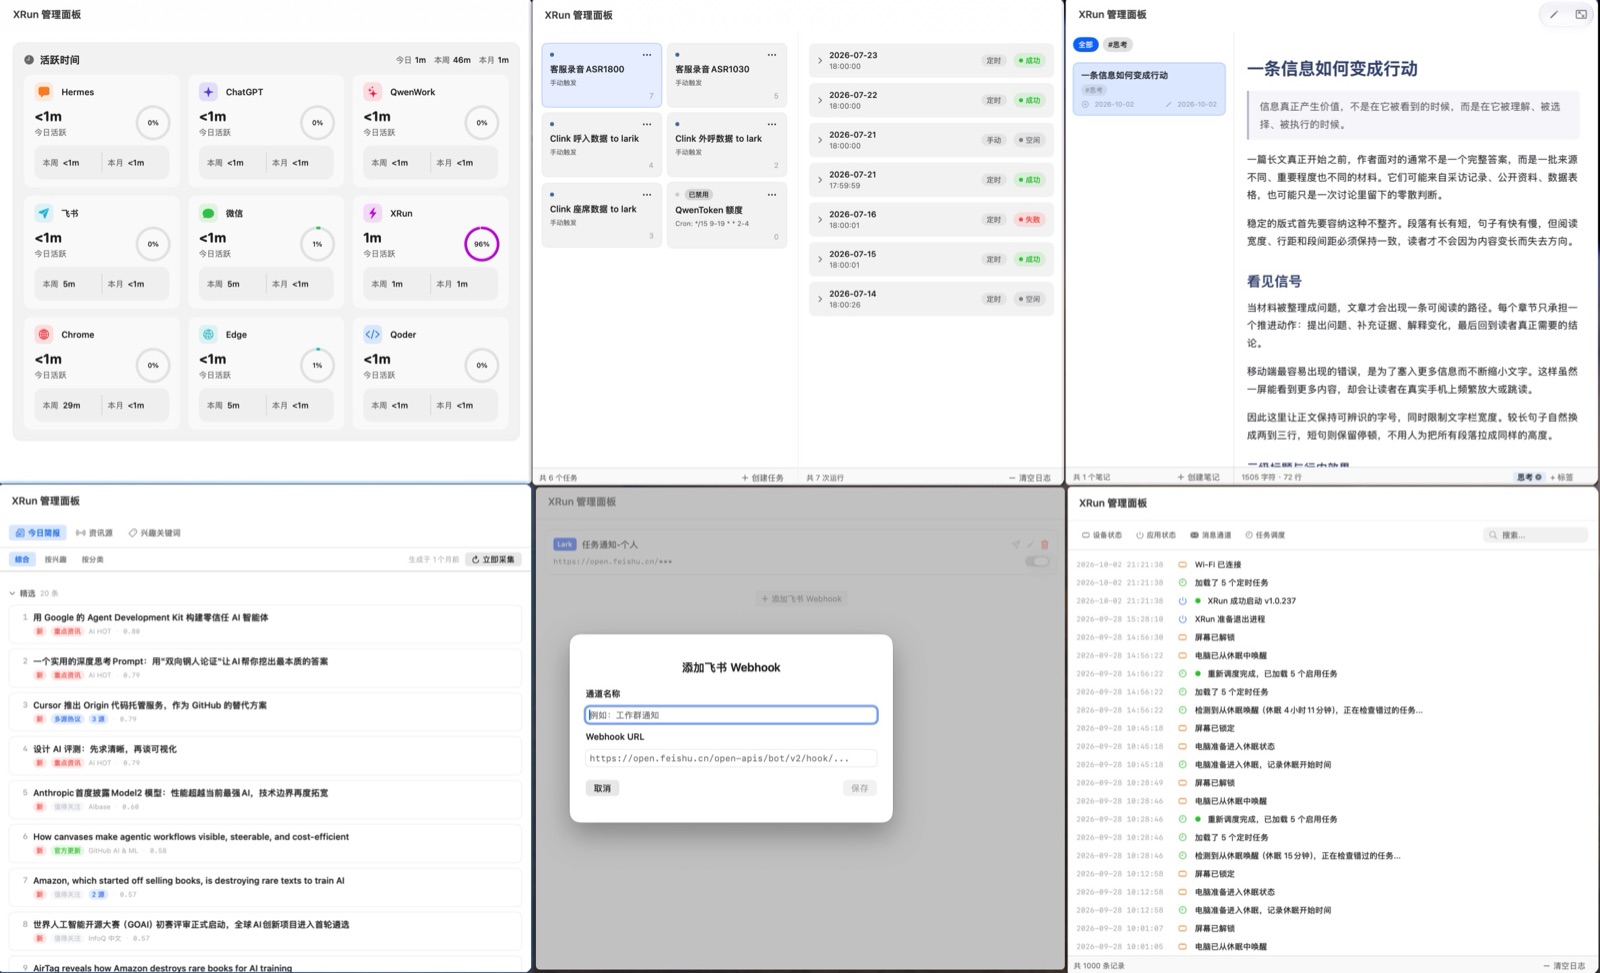
六个模块,围绕同一条主线:让机器干活,人只看结果。
把任意 Python 脚本变成可靠的定时任务。
任务出结果时主动推送,不用等人去查。
随手记录,语法高亮编辑 + 实时预览。
把几十个信息源压成一份「今日简报」。
看得见的时间去向,才有优化的依据。
系统层面发生过什么,全部留痕。
没有引入任何架构框架,用最朴素的「组合根 + Store 模式」控制复杂度。目标很明确:让并发正确、让数据不丢、让功能可以随时加减。
应用采用 MenuBarExtra + Window 双场景:菜单栏负责随时可见的状态,独立窗口负责集中管理。
AppDelegate 作为唯一的组合根统一创建全部 Store、Manager 与 Scheduler 再注入视图,依赖关系集中一处,任何模块都可单独替换。
| 层级 | 代表组件 | 职责 |
|---|---|---|
| 数据层 | TaskStore LogStore NoteStore NewsSourceStore | 状态持有与落盘,统一写入本地应用支持目录 |
| 调度层 | TaskScheduler ScheduleCalculator CronParser | 调度时间计算、进程生命周期、超时与休眠补偿 |
| 服务层 | NotificationManager ShellEnvironment PythonEnvironment SystemObserver | 通知投递、环境探测、系统事件监听 |
| 视图层 | 主分栏视图 + 各模块视图 | 仅做展示与交互,不持有业务状态 |
这里有一个刻意的产品决策:错过就是错过,只记录、不自动补执行。 补执行听起来更智能,但会让「发日报」「清理数据」这类有副作用的脚本在你不知情时突然重跑,风险远大于收益。
三个最值得讲的实现,共同点是:第一版都能跑,但都有隐藏的坑,只有长期使用才会暴露。
最直接的做法是「从当前时间逐分钟往后试,直到命中」。它看似简单,却有两个问题:
性能不可控——用户写 0 3 1 1 *(每年 1 月 1 日凌晨 3 点)时,逐分钟遍历要空转约 52 万次;
语义容易做错——标准 Cron 规定「日期」与「星期」同时被限定(都不为 *)时两者是或关系而非与关系,这个细节大多数简易实现都搞错了。
我的做法是字段级跳跃推进:不匹配时直接跳到该字段的下一个可能取值边界,而不是推进一分钟。
// 月份不匹配 → 直接跳到下月 1 日 00:00,而不是逐分钟试
if !monthSet.contains(month) {
    current = /* 下个月 1 日 00:00 */
    continue
}

// 小时不匹配 → 跳到下一小时的第 0 分
// 分钟不匹配 → 才真正前进一分钟(最小粒度)

// 标准语义:日期与星期同时被限定时取「或」
if dayRestricted && weekdayRestricted {
    if !dayMatches() && !weekdaySet.contains(cronWeekday) {
        current = startOfNextDay(current)
        continue
    }
}
CronParser.swift · 字段级跳跃推进与星期/日期「或」语义
完整实现还覆盖了这些边界:
*、*/n、单值、a-b 区间、a-b/s 与 n/s 步长、逗号组合列表(如 1-5,10-20/2)L 表示当月最后一天,不能当静态集合预解析,必须在匹配时动态计算;星期字段 7 与 0 都表示周日,需归一化5-1 表示周五、六、日、一最坏情况下(刚跑完年度任务就立刻求解下一次)也只需 123 次跳跃,对应 52.6 万次逐分钟推进,实测快约 4,300 倍;搜索有明确上限,遇到永不可能命中的非法组合(如 2 月 30 日)会安全退出并记录警告,而不是卡死主线程。
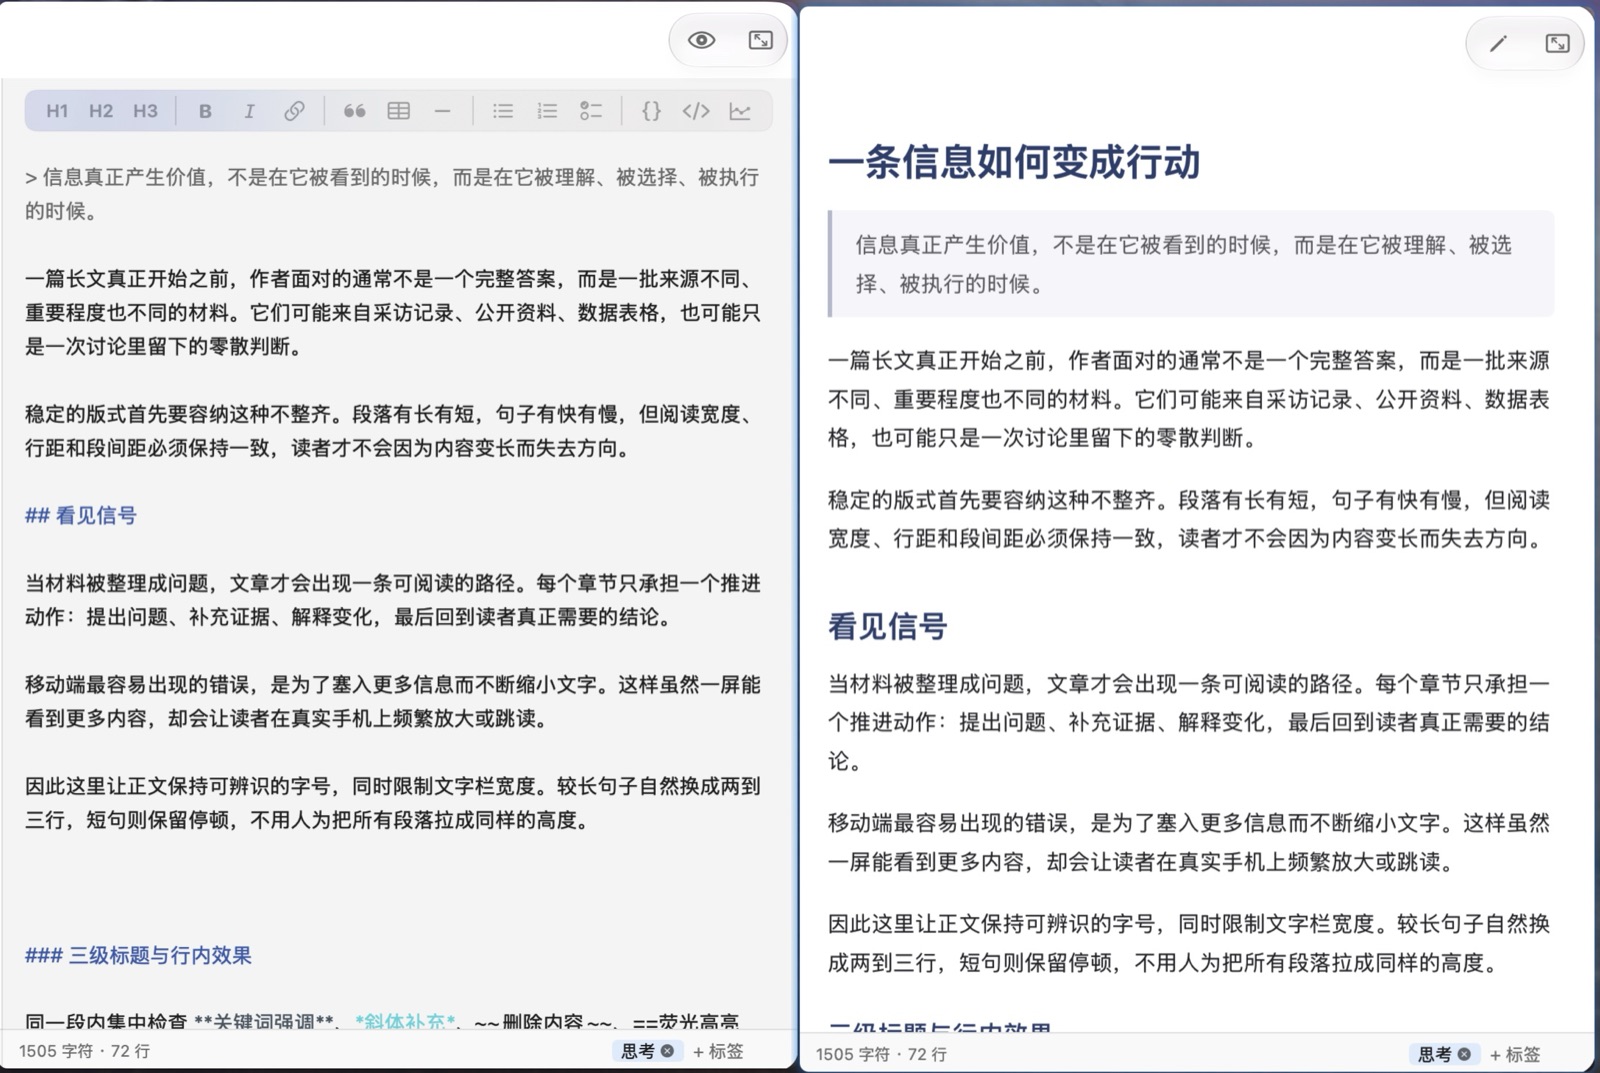
笔记模块需要真正好用的 Markdown 编辑器,声明式框架自带的文本组件能力太弱,必须用 AppKit 的原生文本视图——而两者桥接是出了名的坑区。 最常见的错误做法是双向绑定:视图存一份正文,用户输入后更新状态,状态变化再写回组件,结果就是中文输入法正在候选、 或程序化插入文本时,光标被重置到文首、输入被吞。
我的解法是彻底切断回写路径——这是整个模块最重要的一条架构决策:
// updateNSView 故意留空:绝不把视图状态写回文本组件
func updateNSView(_ nsView: MarkdownTextView, context: Context) {
    // 正文的生命周期完全留在 AppKit 闭环内
}

// 切换笔记时不做增量 diff,而是整体重建编辑器
MarkdownEditorView(initialContent: session.content)
    .id(session.meta.id)   // 换笔记 = 换视图身份
MarkdownEditorView.swift · 以整体重建替代状态同步
编辑过程中三条支路彼此独立:
另外三个细节,都是踩过坑之后才写对的:
上线后再没出现过「光标跳走」或「输入被吞」。预览侧把 Markdown 解析成语法树、遍历生成 HTML 交给系统浏览器组件渲染,表格、代码块、Mermaid 图表都能得到原生级排版并支持全文选择复制;3.5 MB 的图表库只在笔记真的出现该语法时才加载。
这是算法密度最高的部分:用 Python 实现了一条完整数据管线,从 26 个异构源抓取内容,经去重、打分、聚类、筛选,输出一份「今日简报」。最近一轮的实际运行结果:
朴素做法是「标题相同即去重」,但同一事件的标题几乎不会完全相同。方案是三层递进:
这里有个容易被忽略、也最危险的反例:不同厂商的新闻标题往往高度相似(只差一个厂商名),纯相似度聚类会把它们错误合并,导致漏看信息。 为此加了一道实体守卫:先从标题抽取厂商、产品、模型等实体集合,若两边都非空且完全不相交,则无论相似度多高都拒绝合并。
排序若只按相关性,结果是每天被同一类内容淹没。最终重要性评分由四个因子加权构成,每个因子都可解释:
| 因子 | 权重 | 含义 |
|---|---|---|
| 相关性 | 0.30 | 与兴趣关键词的匹配程度;未命中不归零,保留基线分 |
| 来源权威度 | 0.25 | 官方 > 媒体 > 达人 > 社区 |
| 热度 | 0.25 | 报道该故事的独立信源数量与平台侧热度指标,取较大值 |
| 时效性 | 0.20 | 以 48 小时为半衰期的衰减函数,避免旧闻长期占据头部 |
最后是多样性约束:贪心选取前 20 条时,每选中一条就对该来源的后续条目施加惩罚,同时对已选故事做相似度抑制——让简报覆盖不同信源与话题,而不是变成某个网站的头条搬运。
26 个源格式与稳定性各不相同,管线做了三件事:并发抓取并做逐源异常隔离,任何一个源挂掉都不影响其余; 每完成一个源就原子写一次状态文件,宿主应用轮询即可显示实时进度,无需设计流式协议; 以及时区错标纠正——部分平台会把时间标成错误时区,导致内容显示为「未来」或被时间窗过滤掉,需要识别并回正。
这条管线配有 26 个单元测试,覆盖 URL 归一化、日期解析(含时区错标)、相似度计算、实体守卫正反例、去重择优、重要性归一化、归档与关注源筛选等边界场景,全部不依赖网络。
一个人长期维护的项目,最怕的不是功能不够,而是自己半年后不敢改。所以我把「可交付、可回归、可信任」也当成功能来做。
项目不用 Xcode 工程,而是纯 Swift Package Manager 加一个构建脚本。执行 ./build.sh 会自动完成:
编译 → 递增构建号 → 更新应用包信息 → 打包资源(含 Python 管线)→ 重新签名 → 关闭旧实例 → 启动新版本。
版本号策略上有两个刻意的设计:
另有 --commit 模式可在构建成功后自动提交,但要求工作区必须干净——防止代码改动被悄悄混进「构建」提交。
| 风险点 | 处理方式 |
|---|---|
| 通知外发地址 | 强制 HTTPS;域名白名单仅允许官方域名,防止任务内容被推送到任意第三方地址 |
| 网络抖动 | 对限流与服务器错误做指数退避重试,并区分「请求失败」与「业务返回失败」 |
| Python 解释器 | 校验文件头的可执行文件魔数,拒绝脚本冒充解释器;探测时加超时,防止恶意程序挂起应用 |
| Shell 环境捕获 | 只允许白名单内的 shell,不接受任意环境变量指定的路径 |
| 笔记预览 | 过滤危险协议链接,渲染前对全部文本做转义 |
| 日志与截图 | 通知地址在界面与日志中均做脱敏,不完整落盘 |
测试方面保持诚实:Python 管线有 26 个单元测试(算法集中、纯函数、收益最高);Swift 侧目前依赖「纯逻辑函数 + 长期自用」, 尚未补上自动化测试——这是我明确记录的短板,不是被忽略的空白。
另一个值得一提的习惯是自驱式代码审查:提交历史里能看到我按 P0 到 P3 的优先级分批整改——凭证迁移、强制 HTTPS、线程隔离标注、 资源释放配对、强制解包清理、日志统一、为关键算法补测试。这些提交没有外部评审人,纯粹是「用了一段时间后回头看,觉得这里不对」。
成果之一是:整个 11,615 行代码库目前只留有 1 处待办标记,且带明确的优先级与改进方案。
以下数据全部来自应用在本机的真实运行记录(读取本地数据文件统计),不是估算值。我认为「自己每天在用」本身就是最硬的验收标准。
| 指标 | 实测值 |
|---|---|
| 代码规模 | Swift 11,615 行 / 57 个文件;Python 管线 2,277 行 |
| 第三方依赖 | 仅 1 个开源 Markdown 解析库,其余全部自研 |
| 版本迭代 | v1.0.237(237 个构建版本),37 次提交,代码变更累计 +30,769 / −12,514 行 |
| 资讯采集 | 26 个源在线(RSS 15 / JSON API 7 / 网页 3 / Atom 1);最近一轮抓取 521 条 → 合并为 479 个故事 → 精选 20 条,0 源失败 |
| 任务执行 | 6 个任务在管(5 个启用),累计 27 个执行批次、462 条执行日志 |
| 系统事件 | 累积记录 1,000 条(恰好触达设计上限,反向验证容量截断策略生效) |
| 活跃统计 | 连续记录 2 个月(2026-07-24 → 2026-09-27),覆盖 9 个应用 |
| 稳定性 | 长期常驻运行无崩溃;异常退出后的状态自愈机制已就位 |
这个项目曾经有过「服务管理」和「待办事项」两个模块,功能都是完整的,后来我把它们删掉了。 原因很直接:它们不在我每天的真实动线上。服务管理更适合专业运维工具,待办事项我最终选择了更顺手的方案。 留着只会增加维护面、让定位变模糊。删掉近千行能跑的代码,是比写新功能更重要的决定。
长期方向是让它从「脚本调度器」逐步长成一个个人自动化中枢:不只是按时执行,而是能把多个环节编排成工作流,并对外提供可复用的能力。
XRun 对我而言不只是一个 App。它证明了一件事:懂业务的人,可以把需求直接变成可运行的系统——中间不需要翻译,也不会有需求失真。
它回答了一个具体问题:当一个运营人说要「用自动化提效」,他能做到多深?我的答案是——深到可以自己写出工具本身。
全部数据存放在本地 ~/Library/Application Support/XRun/,格式为可读的 JSON 与 Markdown,不依赖任何云服务。